[1-day] CVE-2026-57137
이번에 분석한 취약점은 PraisonAI의 npm 패키지에 존재하는 도구 승인 우회 취약점이다.
LLM 에이전트는 파일 쓰기, 명령 실행, 외부 API 호출처럼 실제 부작용이 있는 도구를 사용할 수 있다. 이때 사람이나 정책 엔진이 실행 전에 승인하도록 만드는 것이 onToolCall의 역할이다. 그런데 취약 버전에서는 승인 콜백이 도구 실행 후 호출됐다.
결과적으로 사용자가 승인을 거절하더라도 도구의 부작용은 이미 발생한 상태가 된다. 응답에는 tool_rejected가 표시돼 차단된 것처럼 보이기 때문에 로그만 확인하면 정상적으로 보호됐다고 오해할 수도 있다.
Advisory
1
2
3
4
5
Affected Version
>= 1.4.0, <= 1.7.1

Patched Version
1.7.2
OnToolCall은 승인 콜백으로 문서화됐지만, 실행 가능한 도구를 AI SDK의 generateText()에 먼저 전달해 도구가 실행된 뒤 승인 여부를 확인한다.
취약점은 PraisonAI가 기본 네트워크 서비스를 노출한다는 의미가 아니다. 이 라이브러리는 사용하는 애플리케이션이 낮은 신뢰도의 프롬프트를 받고, 파일, 셸, API, DB와 같은 강력한 도구를 등록하고, onToolCall을 보안 경계로 사용해야 실제 영향이 발생한다.
분석 환경 구축
Dockerfile
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
FROM node:22-bookworm

RUN apt-get update && apt-get install -y --no-install-recommends \
    git \
    ripgrep \
    jq \
    diffutils \
    vim \
    less \
    ca-certificates \
    && rm -rf /var/lib/apt/lists/*

WORKDIR /lab

CMD ["/bin/bash"]
취약 버전과 패치 버전 확보
먼저 npm 레지스트리에서 배포 정보를 확인했다.
1
2
npm view praisonai@1.7.1 version dist.tarball dist.integrity --json
npm view praisonai@1.7.2 version dist.tarball dist.integrity --json
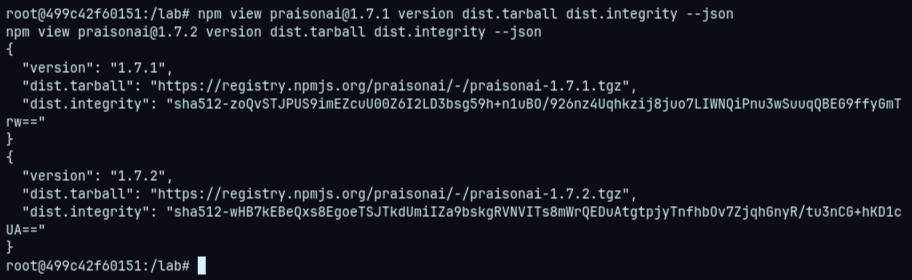
1.7.1과 1.7.2 두 패키지를 직접 받는다.
1
2
3
4
5
6
7
8
9
10
11
12
mkdir -p /lab/pkg/1.7.1 /lab/pkg/1.7.2
cd /lab/pkg

npm_config_loglevel=silent npm pack praisonai@1.7.1
npm_config_loglevel=silent npm pack praisonai@1.7.2

tar -xzf praisonai-1.7.1.tgz -C 1.7.1 --strip-components=1
tar -xzf praisonai-1.7.2.tgz -C 1.7.2 --strip-components=1

jq -r '.name + "@" + .version' \
  1.7.1/package.json \
  1.7.2/package.json
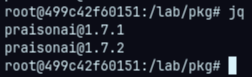
Patch Diff
dist/ai/agent-loop.js
1
2
3
diff -u \
  /lab/pkg/1.7.1/dist/ai/agent-loop.js \
  /lab/pkg/1.7.2/dist/ai/agent-loop.js | less
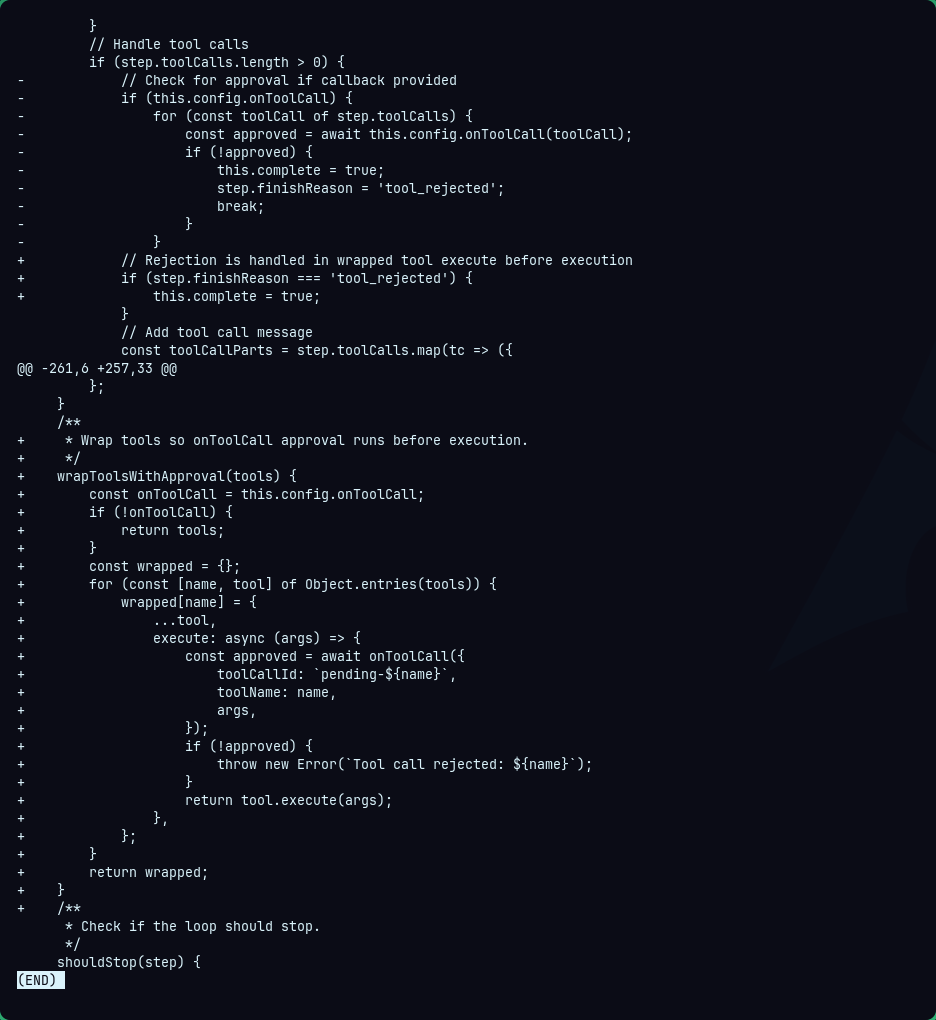
패치 내용은 크게 세 부분이다.
생성자에서 도구 래핑
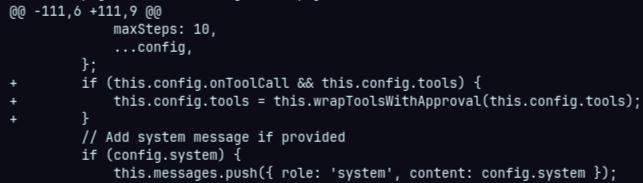
onToolCall과 도구가 함께 설정되면 원본 도구를 그대로 사용하지 않고 승인 로직으로 감싼다.
실행 후 승인 로직 제거
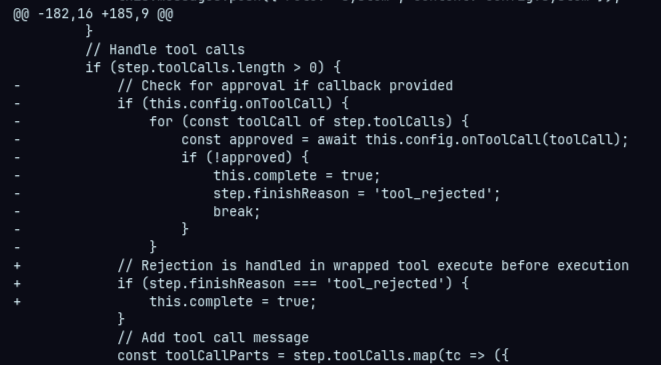
취약 버전에서 generateText()가 끝난 뒤 수행되던 승인 검사가 제거됐다.
원본 execute 앞에 승인 검사 추가
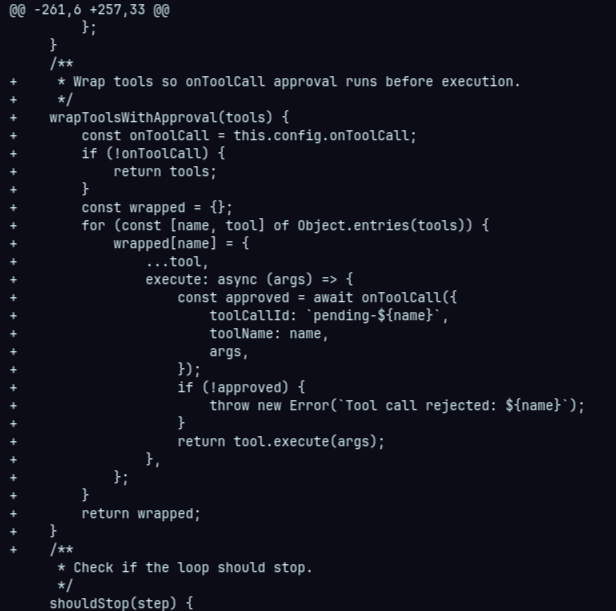
패치 버전은 wrapper의 execute() 안에서 승인을 먼저 요청한다. 거절되면 예외를 발생시키고 원본 tool.execute(args)에는 도달하지 않는다.
취약 코드 분석
취약 버전의 핵심 코드를 줄 번호와 함께 확인했다.
1
nl -ba /lab/pkg/1.7.1/dist/ai/agent-loop.js | sed -n '145,202p'
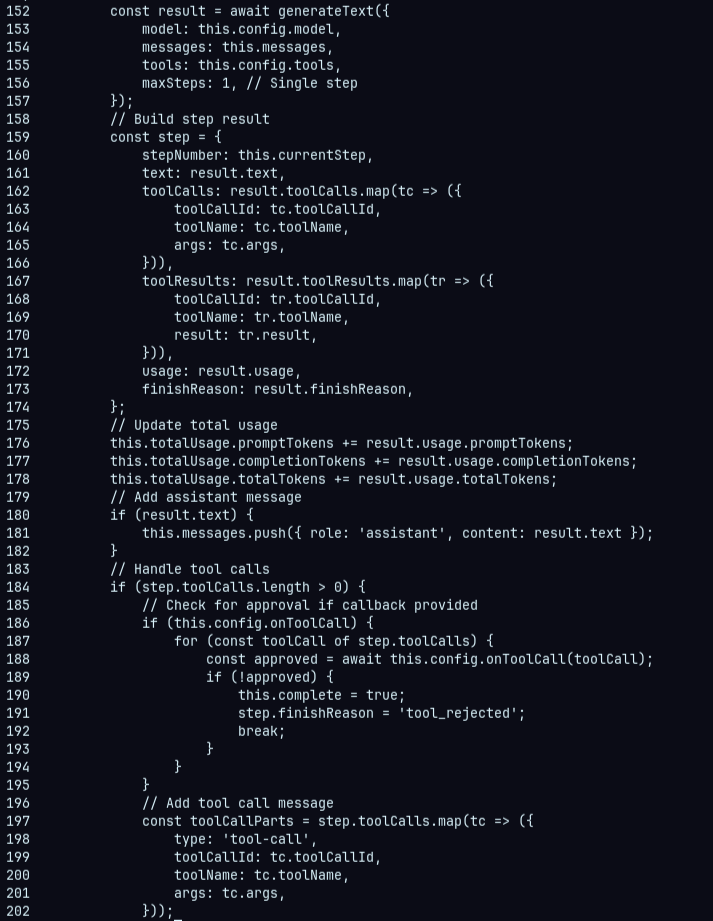
onToolCall()에 도달했을 때는 이미 generateText()가 반환됐고, toolResults도 존재한다. PraisonAI의 wrapper가 AI SDK에 무엇을 전달하는지도 확인했다.
1
nl -ba /lab/pkg/1.7.1/dist/ai/generate-text.js | sed -n '153,190p'
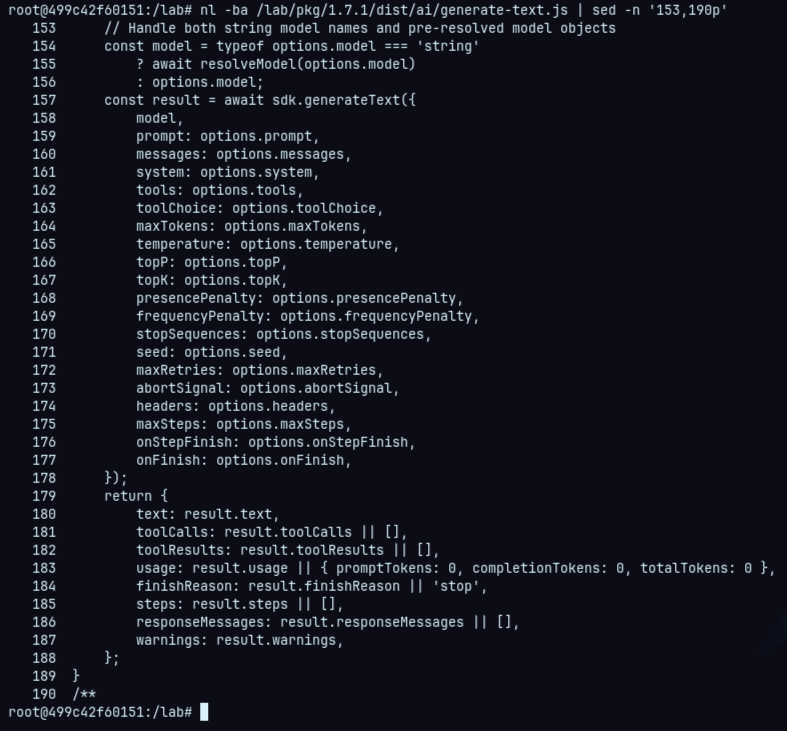
실행 가능한 도구가 별도 변환 없이 AI SDK에 전달된다. AI SDK는 execute 함수가 있는 도구를 모델이 호출하면 기본적으로 그 함수를 실행한다. 따라서 PraisonAI가 나중에 승인 콜백을 호출해도 이미 발생한 부작용을 되돌릴 수 없다.
Root Cause
근본 원인은 승인 검사를 결정 시점이 아니라 결과 처리 시점에 배치한 것이다. 보안 경계가 되려면 순서가 다음과 같아야 한다.
1
도구 호출 의도 생성 -> 승인 요청 -> 승인된 경우에만 실행 -> 결과 생성
취약 버전은 다음 순서였다.
1
도구 호출 의도 생성 -> 도구 실행 -> 결과 생성 -> 승인 요청 -> 거절 표시
즉, onToolCall은 이름과 문서상으로는 승인 hook이지만 실제 동작은 실행 후 감사 hook에 가까웠다.
이 문제는 단순히 결과 상태가 잘못 표시되는 UI 버그가 아니라 예를 들어 원본 도구가 다음 중 하나람ㄴ 거절 전에 실제 영향이 발생한다.
- 파일 생성, 수정, 삭제
- 셸 명령 실행
- 데이터베이스 변경
- 결제 또는 메시지 전송 API 호출
- 프로세스 권한으로 접근 가능한 정보 조회
“tool_rejected”는 이미 실행된 작업을 rollback하지 않는다.
취약 동작 재현
실제 파일이나 명령을 변경하지 않도록 부작용은 메모리 카운터 증가로 대체했다. 또한 API키와 외부 LLM 없이 재현하기 위해 AI SDK 6.0.3의 MockLanguageModelV3를 사용했다.
의존성 설치
1
2
3
npm init -y
npm install --save-exact ai@6.0.3
vim /lab/poc.js
PoC
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
const path = require('path');
const { jsonSchema } = require('ai');
const { MockLanguageModelV3 } = require('ai/test');

const version = process.argv[2];
const packageRoot = `/lab/pkg/${version}`;
const { createAgentLoop } = require(
  path.join(packageRoot, 'dist/ai/agent-loop.js'),
);

const events = [];
let sideEffects = 0;

const model = new MockLanguageModelV3({
  doGenerate: async () => ({
    content: [{
      type: 'tool-call',
      toolCallId: 'call-1',
      toolName: 'dangerousWrite',
      input: JSON.stringify({ value: 'local-test' }),
    }],
    finishReason: { unified: 'tool-calls', raw: 'tool_calls' },
    usage: {
      inputTokens: { total: 1, noCache: 1, cacheRead: 0, cacheWrite: 0 },
      outputTokens: { total: 1, text: 0, reasoning: 0 },
    },
    warnings: [],
  }),
});

async function main() {
  const schema = jsonSchema({
    type: 'object',
    properties: { value: { type: 'string' } },
    required: ['value'],
    additionalProperties: false,
  });

  const loop = createAgentLoop({
    model,
    maxSteps: 1,
    tools: {
      dangerousWrite: {
        description: 'harmless test tool',
        inputSchema: schema,
        parameters: schema,
        execute: async () => {
          events.push('tool-executed');
          sideEffects += 1;
          return { ok: true };
        },
      },
    },
    onToolCall: async () => {
      events.push('approval-denied');
      return false;
    },
  });

  loop.addMessage({ role: 'user', content: 'Run the test tool' });
  const step = await loop.step();

  console.log(JSON.stringify({
    praisonaiVersion: version,
    aiSdkVersion: require('ai/package.json').version,
    eventOrder: events,
    sideEffects,
    finishReason: step.finishReason,
    toolCallCount: step.toolCalls.length,
    toolResultCount: step.toolResults.length,
    vulnerable:
      sideEffects > 0 &&
      events.indexOf('tool-executed') < events.indexOf('approval-denied'),
    blocksBeforeExecution:
      sideEffects === 0 && events[0] === 'approval-denied',
  }, null, 2));
}

main().catch((error) => {
  console.error(error);
  process.exit(1);
});
테스트 모델은 항상 dangerousWrite 호출 의도를 반환한다. 실제 도구의 execute()가 실행되면 tool-executed 이벤트와 카운터가 기록된다. 승인 콜백은 무조건 false를 반환하며 approval-denied를 기록한다.
따라서 이벤트 배열만 확인해도 실행과 승인 중 무엇이 먼저 발생했는지 알 수 있다.
Vulnerable Version Test
1
node /lab/poc.js 1.7.1
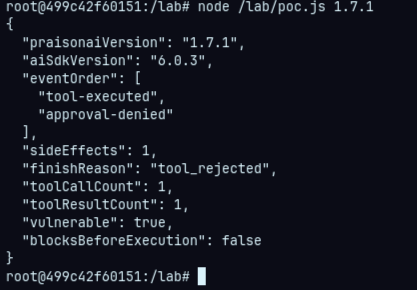
결과에서 세 가지를 확인할 수 있다.
- 이벤트 순서가
tool-executed -> approval-denied다. - 승인을 거절했지만
sideEffects가 1이다. finishReason은tool_rejected인데toolResultCount도 1이다.
즉 외형상 거절 상태이지만 도구는 이미 한 번 실행됐다.
Fixed Version Test
동일한 PoC에서 패키지 버전만 1.7.2로 바꿨다.
1
node /lab/poc.js 1.7.2
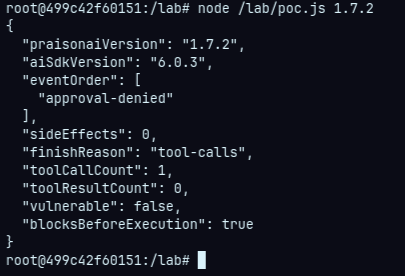
이번에는 approval-denied만 기록되고 tool-executed는 발생하지 않았다. sideEffects와 toolResultCount도 모두 0이다. 패치의 wrapper가 원본 execute()보다 먼저 승일 콜백을 호출했고 거절 시 원본 실행을 차단한 것이다.
여기서 한 가지 관찰할 점은 AI SDK 6.0.3을 사용한 실제 테스트에서 패치 버전의 finishReason이 tool_rejected가 아니라 tool-calls였다는 것이다. AI SDK는 wrapper가 던진 실행 오류를 tool error로 처리하지만 모델의finish reason은 그대로 유지할 수 있다. 핵심 보안 속성인 거절된 원본 도구가 실행되지 않음은 만족했지만, 전체 run() 흐름의 종료, 재시도 정책은 별도 회귀 테스트로 확인하는 것이 안전하다.