[V8] JIT Compilation
JavaScript는 사람이 읽을 수 있는 고수준 프로그래밍 언어이다. 하지만 CPU는 JavaScript 소스 코드를 직접 이해하거나 실행할 수 없기 때문에 소스코드를 CPU가 실행할 수 있는 형태로 변환하는 과정이 필요하다.
이때 사용할 수 있는 대표적인 방식으로는 다음 세 가지가 있다.
- AOT Compliation
- Interpreter
- JIT Compilation
현대 JavaScript 엔진은 보통 인터프리터와 JIT 컴파일러를 함께 사용한다. 처음에는 비교적 빠르게 실행하고 실행 과정에서 수집한 정보를 이용해 반복적으로 실행되는 코드를 기계어로 컴파일하고 최적화한다.
V8 역시 이러한 구조를 사용한다. V8은 JavaScript를 바이트코드로 변환하고 처음에는 Ignition 인터프리터로 바이트코드를 실행한다. 이후 필요에 따라 Sparkplug, Maglev, TurboFan과 같은 컴파일러를 이용해 코드를 기계어로 변환하고 최적화한다.
코드 실행 과정
소스 코드와 기계어
1
2
3
4
5
function add(a, b); {
  	return a + b;
}

console.log(add(10, 20));
개발자는 function, return, + 와 같은 문법을 보고 코드의 의미를 이해할 수 있다. 하지만 CPU는 이러한 문법을 직접 이해하지 못한다.
CPU는 다음과 같은 저수준 명령을 실행한다.
- 레지스터에 값을 저장한다.
- 두 레지스터와 값을 더한다.
- 특정 메모리 주소로 이동한다.
- 조건에 따라 다른 명령으로 분기한다.
- 함수를 호출한다.
따라서 고수준 언어로 작성된 프로그램을 실행하려면 소스 코드를 기계어로 변환하거나 다른 프로그램이 소스 코드의 의미를 해석해서 대신 실행해야 한다.
이 변환 시점과 실행 방식에 따라 AOT 컴파일, 인터프리터, JIT 컴파일로 구분할 수 있다.
AOT Compliation
AOT는 Ahead-Of-TIme Compliation의 약자이다.
프로그램을 실행하기 전에 소스 코드 전체를 미리 기계어로 컴파일하는 방식이다. C와 C++ 프로그램은 일반적으로 이러한 방식으로 실행 파일을 생성한다.
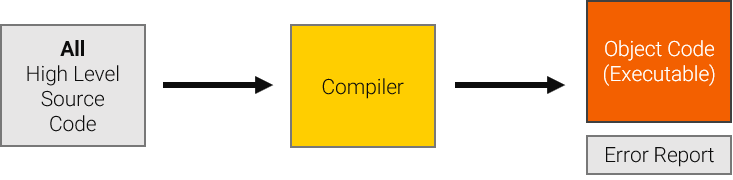
프로그램을 컴파일하면 소스 코드가 현재 운영체제와 CPU 아키텍처에 맞는 실행 파일로 변환된다.
이후 프로그램을 실행할 때는 이미 기계어가 생성되어 있으므로 CPU가 해당 기계어를 직접 실행할 수 있다.
AOT 방식의 주요 장점은 실행 전에 컴파일이 완료되어 있다는 것이다. 프로그램 실행 중에 소스 코드를 해석하거나 컴파일 하는 비용이 상대적으로 적다.
반면 생성된 기계어는 보통 특정 환경에 종속된다. x86-64용으로 생성한 기계어를 ARM CPU가 그대로 실행할 수 없고 운영체제의 실행 파일 형식와 ABI에도 영향을 받는다.
또한 실행 전에 프로그램에 관한 정보만으로 최적화를 수행해야 한다. 실제 실행 중 어떤 함수가 자주 호출되고 어떤 타입의 값이 전달되는지는 일반적으로 알기 어렵다.
Interpreter
인터프리터는 프로그램을 실행하면서 명령의 의미를 하나씩 해석하고 해당 동작을 수행한다.
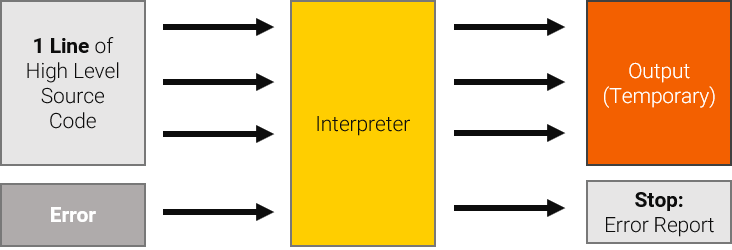
인터프리터가 반드시 원본 소스 코드를 한 줄씩 직접 읽는 것은 아니다. 현대 언어 구현에서는 소스 코드를 먼저 바이트코드와 같은 중간 표현으로 변환한 뒤 인터프리터가 해당 바이트코드를 실행하는 경우가 많다.
예를 들어 다음과 같은 바이트코드가 있다고 가정한다.
1
2
3
4
Load A
Load B
Add
Return
인터프리터는 대략 다음 과정을 반복한다.
- 현재 바이트코드를 읽는다.
- 바이트코드의 종류를 확인한다.
- 해당 바이트코드 핸들러를 실행한다.
- 다음 바이트코드로 이동한다.
이를 Fetch-Decode-Execute와 비슷한 반복 과정으로 볼 수 있다.
Fetch-Decode-Execute
Fetch-Decode-Execute는 CPU가 프로그램의 명령어를 처리하는 가장 기본적인 작동 과정(명령어 사이클)이다.
인터프리터의 장점은 프로그램을 빠르게 실행하기 시작할 수 있다는 것이다. 전체 코드를 복잡하게 분석하고 기계어로 컴파일할 필요 없이 필요한 부분부터 해석해서 실행할 수 있다.
또한 거의 실행되지 않는 함수에 대해 기계어를 생성하지 않아도 되므로 컴파일 시간과 코드 메모리를 절약할 수 있다.
하지만 동일한 코드가 반복 실행되면 문제가 발생한다.
1
2
3
4
5
6
7
function add(a, b) {
  	return a + b;
}

for (let i = 0; i < 10000; i++) {
	add(i, 1);
}
add()가 매우 많이 호출되면 인터프리터는 동일한 바이트코드를 계속 읽고 명령의 종류를 확인하고 해당 핸들러로 이동하는 과정을 반복해야 한다.
실제 덧셈 연산 자체뿐만 아니라 바이트코드를 해석하기 위한 부가 비용이 반복적으로 발생하는 것이다.
JIT Compliation
JIT은 Just-In-Time Compliation의 약자이다.
프로그램을 실행하는 도중에 코드를 기계어로 컴파일하는 방식이다.
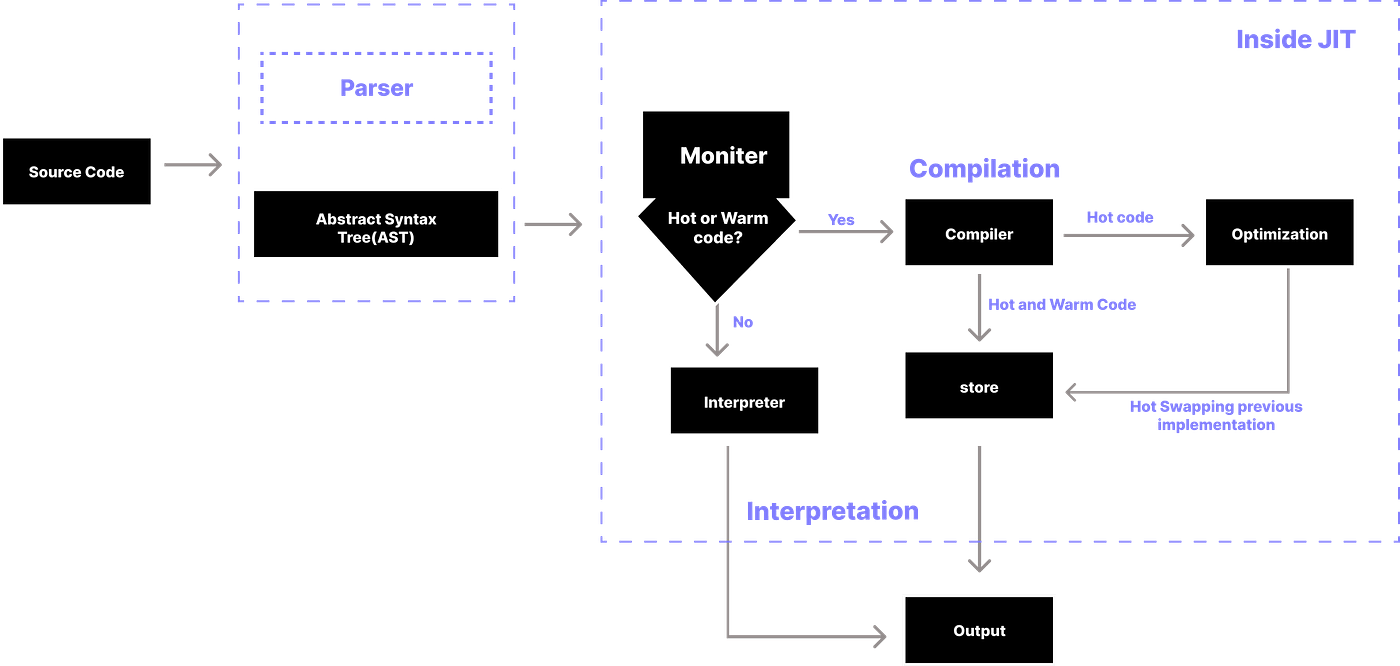
프로그램을 실제로 실행하면서 다음과 같은 정보를 수집할 수 있다는 점이 핵심이다.
- 어떤 함수가 자주 호출되는가
- 어떤 반복문이 많이 실행되는가
- 특정 연산에 어떤 타입의 값이 전달되는가
- 객체가 주로 어떤 구조를 가지는가
- 특정 호출 지점에서 어떤 함수가 주로 호출되는가
JIT 컴파일러는 이러한 실행 정보를 바탕으로 실제 프로그램의 동작에 특화된 기계어를 생성할 수 있다.
지금까지 특정 호출 지점에서 숫자만 전달되었다면 JIT 컴파일러는 앞으로도 비슷한 값이 전달될 가능성이 높다고 추측하고 숫자 연산에 특화된 코드를 생성할 수 있다.
JIT 최적화
JIT 컴파일러의 동작을 이해하려면 다음 흐름을 연결해서 이해해야 한다.
- 코드 실행
- 실행 정보 수집
- 자주 실행되는 코드 탐지
- 수집한 정보를 기반으로 최적화
- 최적화된 기계어 실행
- 가정이 틀리면 Deopimization
바이트코드 실행
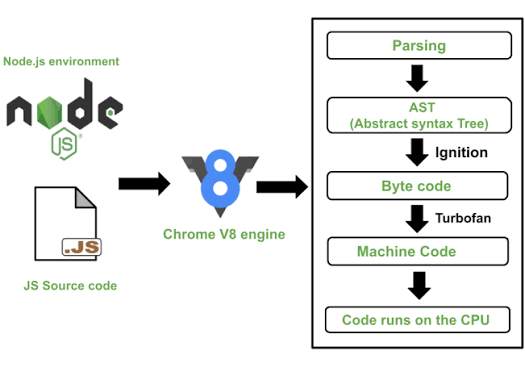
V8에서는 JavaScript 소스 코드가 먼저 파싱된다.
파서는 소스 코드의 문법을 분석하고 AST를 생성한다. AST는 Abstract Syntax Tree의 약자로 소스 코드의 문법 구조를 트리 형태로 표현한다.
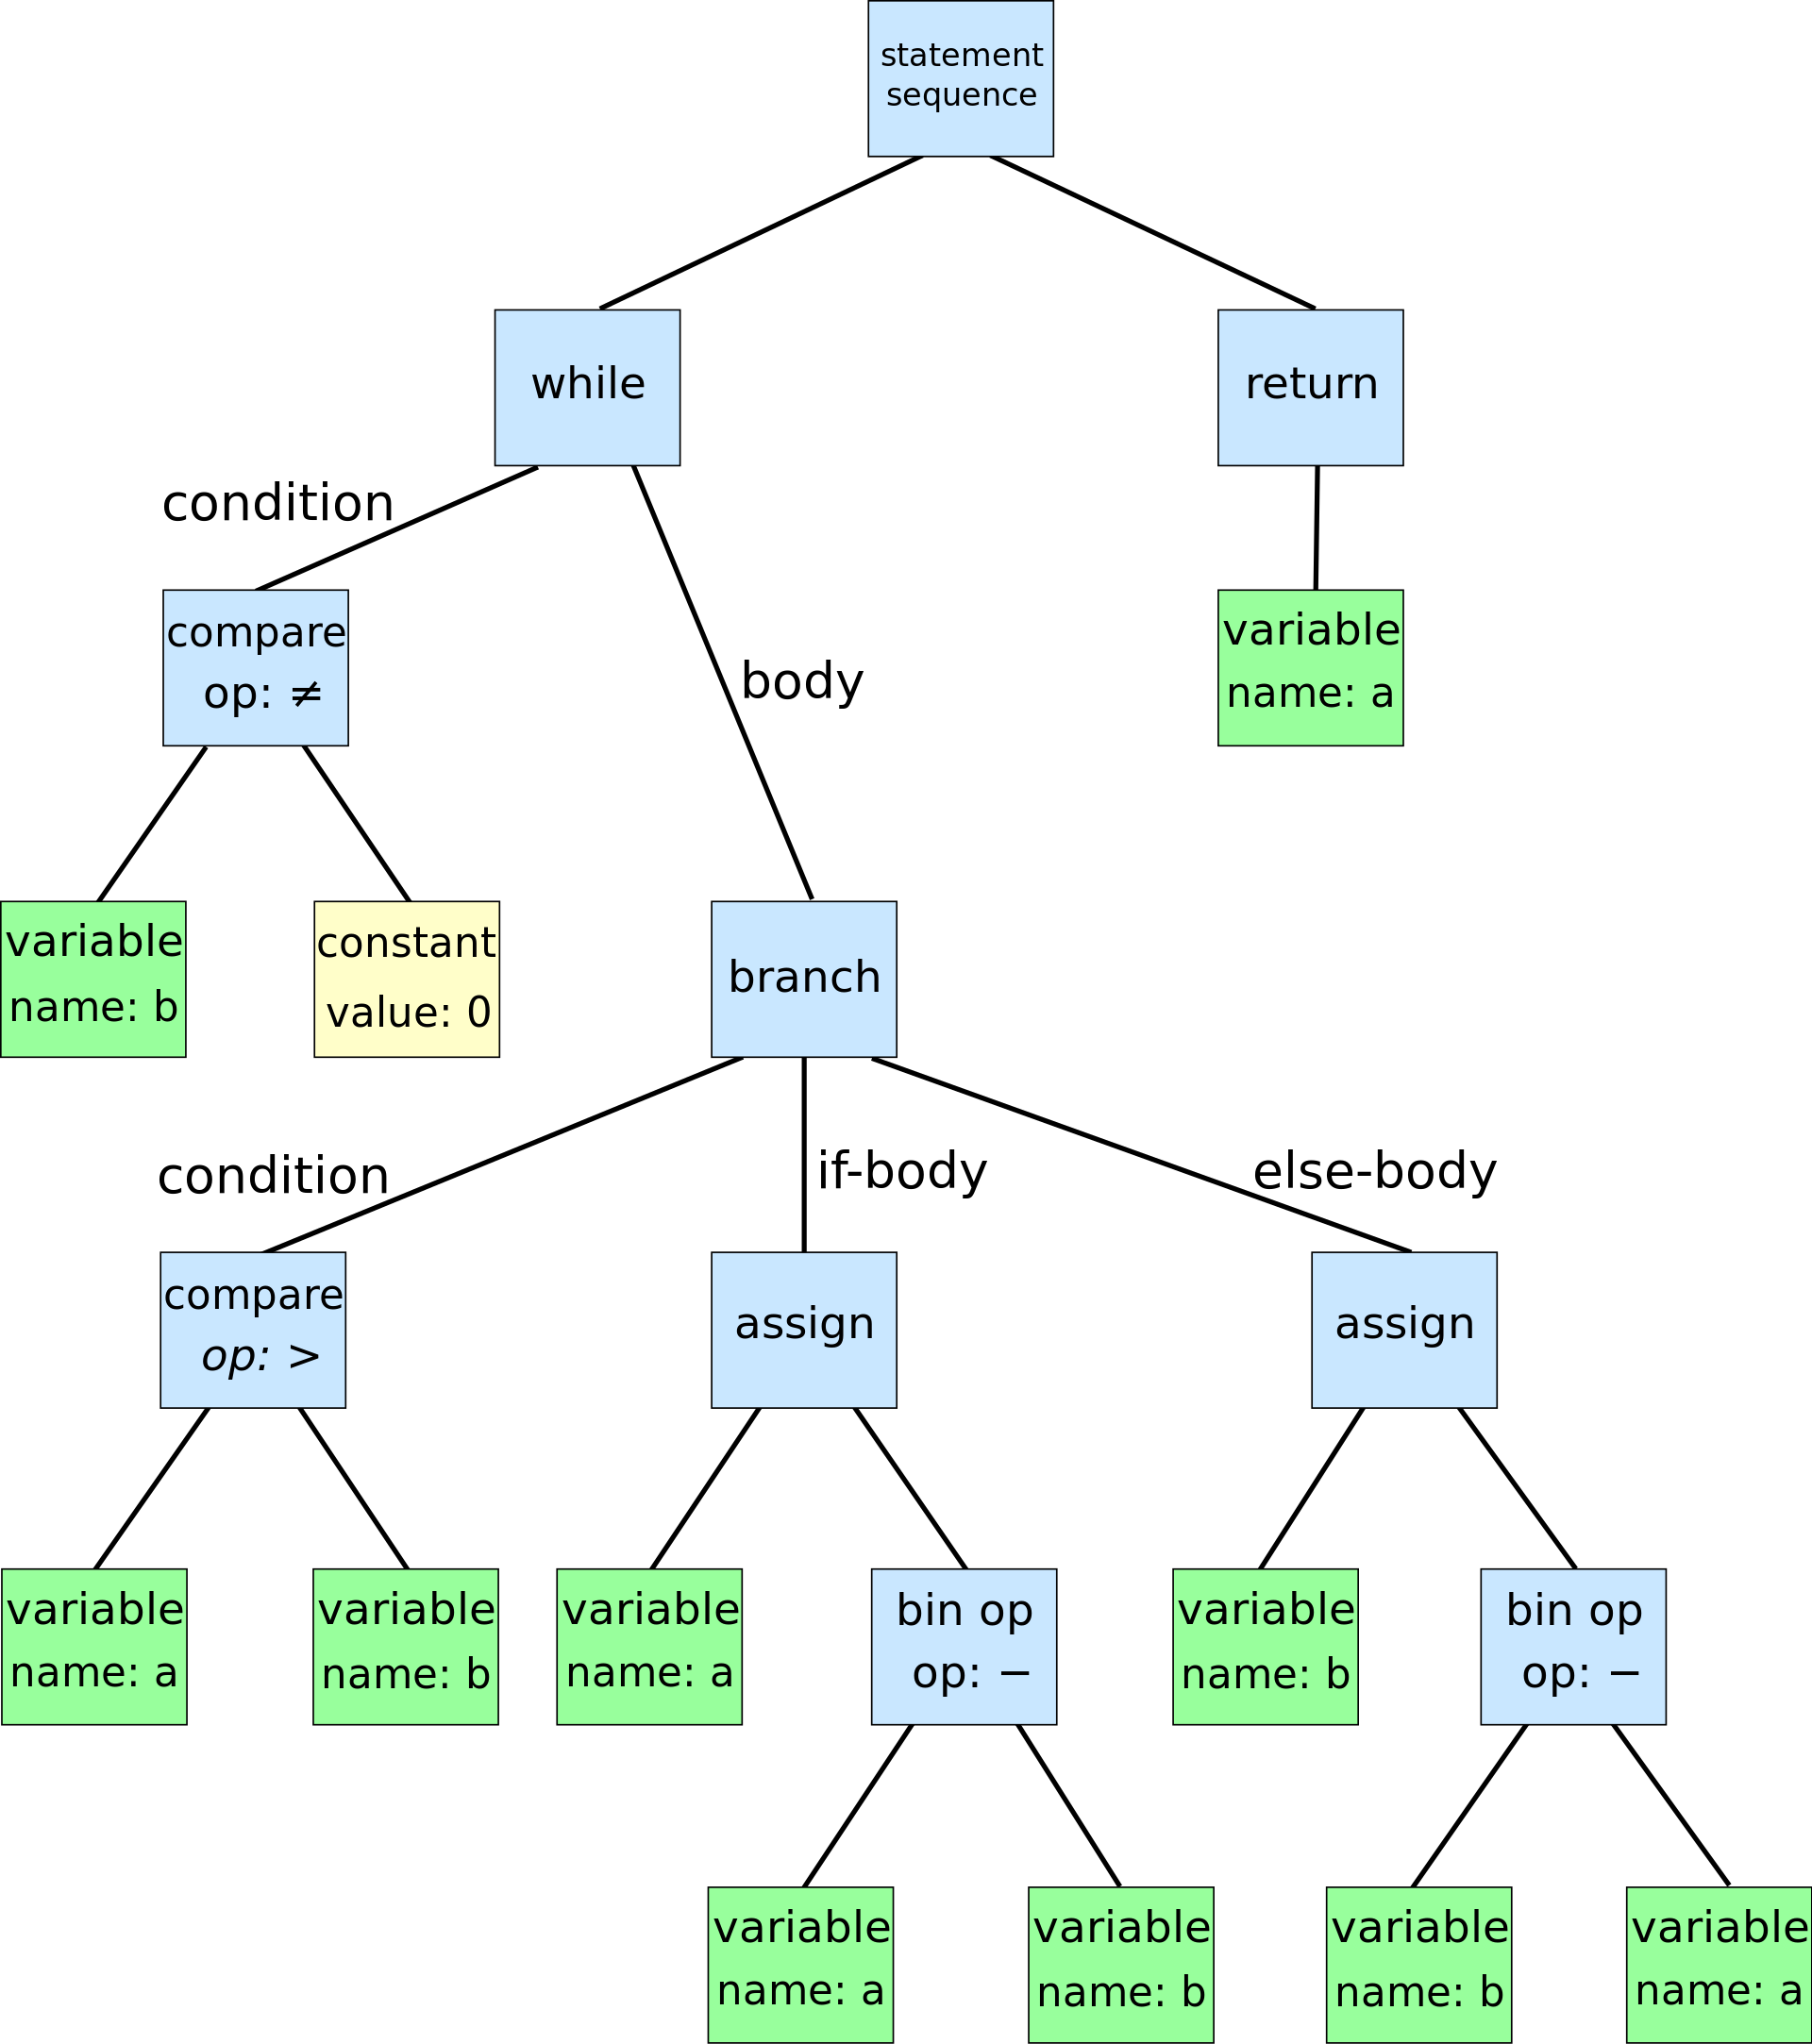
AST는 소스 코드의 구조를 표현하지만 CPU가 직접 실행할 수 있는 기계어는 아니다.
V8의 Ignition bytecode generator는 AST를 입력으로 받아 바이트코드와 실행에 필요한 메타데이터를 생성한다. 생성된 바이트코드는 Ignition 인터프리터가 실행한다.
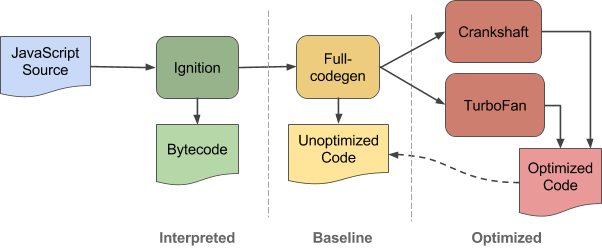
바이트코드는 기계어와 JavaScript 소스 코드 사이에 존재하는 중간 표현이다.
기계어보다 추상적이기 때문에 특정 CPU 아키텍처에 직접 종속되지 않고 원본 JavaScript 소스 코드보다 실행하기 쉬운 형태로 정리되어 있다.
실제 Ignition 바이트코드의 명령과 레지스터 구조는 더 복잡하지만 여기서는 JavaScript의 동작이 더 작은 실행 단위로 변환된다고 이해하면 된다.
Runtime Feedback
JavaScript는 동적 타입 언어이다. 하나의 변수에 서로 다른 종류의 값을 저장할 수 있다.
1
2
3
let val = 10;
val = 1.23;
val = "Hello";
함수의 매개변수 타입 역시 소스 코드만으로 고정되지 않는다.
1
2
3
function add(a, b); {
  	return a + b;
}
이 함수에는 숫자가 들어올 수도 있고 문자열이 들어올 수도 있다.
따라서 V8은 코드를 실행하면서 연산에 전달되는 값의 타입과 객체의 형태 등 여러 정보를 수집한다.
V8은 이러한 정보를 Feedback Vector에 저장한다. 예를 들어 + 연산이나 object.property와 연산에 어떤 타입과 객체 형태가 관찰되었는지 기록하고 이후 최적화 컴파일러가 해당 정보를 이용한다.
최적화 컴파일러는 이 정보를 이용해 일반적인 모든 JavaScript 타입을 처리하는 코드 대신 지금까지 관찰된 입력에 특화된 코드를 생성할 수 있다.
Hot Code
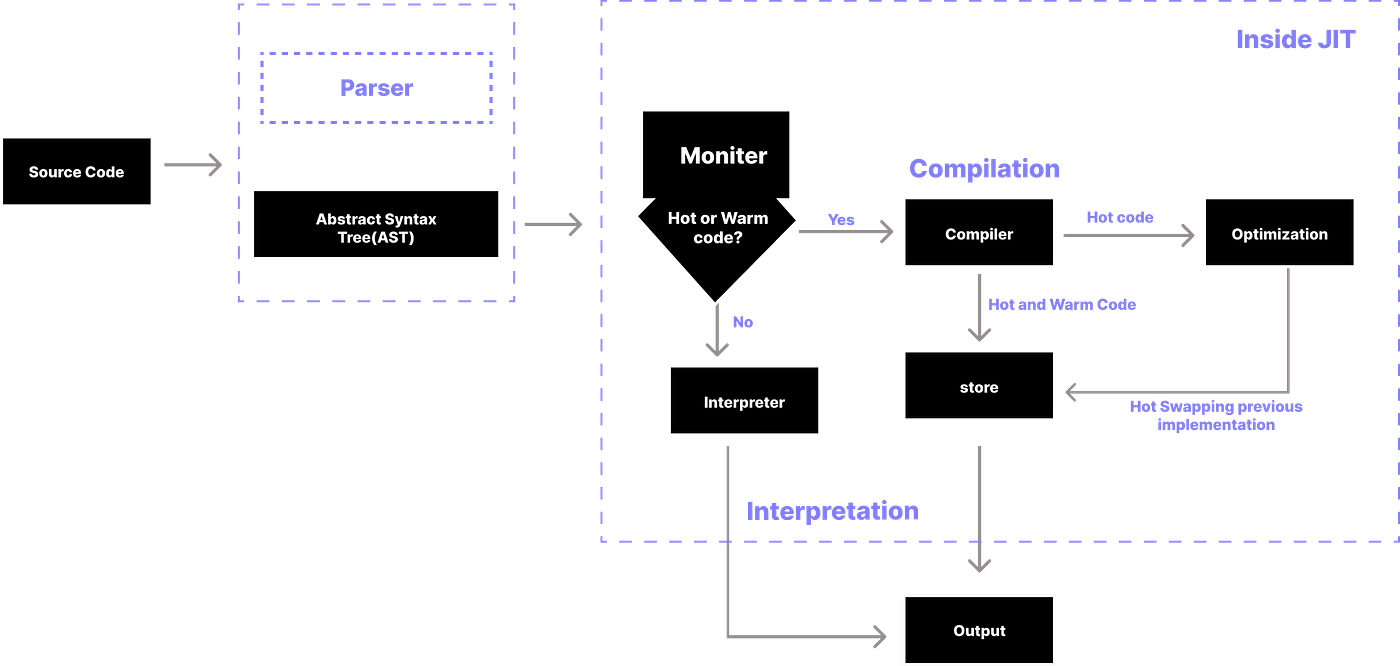
프로그램에 존재하는 모든 코드가 같은 횟수만큼 실행되는 것은 아니다.
함수1이 한 번만 실행되고 함수2가 수십만번 실행된다면 두 함수에 같은 수준의 컴파일 비용을 사용하는 것은 비효율적이다.
한번만 실행되는 함수를 최적화하는데 10의 비용을 사용했는데 최적화를 통해 절약하는 비용이 1이라면 전체적으로 손해이다.
반면 백만번 실행되는 함수를 최적화해서 각 호출마다 적은 비용을 줄일 수 있다면 처음에 사용한 컴파일 비용을 충분히 회수할 수 있다.
1
2
3
4
5
6
7
8
9
10
11
최적화 비용: 100

한 번 실행되는 함수:
실행 시간 절약: 2
→ 최적화하지 않는 편이 유리할 수 있음


백만 번 실행되는 함수:
호출당 실행 시간 절약: 1
총 절약 비용: 1,000,000
→ 최적화하는 편이 유리함
이처럼 자주 호출되는 함수나 반복적으로 실행되는 코드 영역을 일반적으로 Hot Code라고 한다.
반대로 실행 빈도가 낮은 코드는 Cold Code라고 부른다.
V8은 실행 횟수와 내부 판단을 바탕으로 어떤 코드를 더 높은 컴파일 단계로 올릴지 결정한다. 정확한 임계값과 조건은 V8 버전 및 내부 구현에 따라 달라질 수 있기 때문에 정확히 몇번 호출이면 최적화된다 라고 단정지을 순 없다..
Speculative Optimization
JIT 컴파일러는 실행 중 수집한 정보를 바탕으로 특정 조건이 앞으로도 유지될 것이라고 추측한다.
이를 Speculative Optimization(추측적 최적화) 라고 한다.
1
2
3
4
5
6
7
function add(a, b) {
  	return a + b;
}

for let i = 0; i < 100000; i++) {
  	add(i, 1);
}
add() 함수의 a와 b에는 반복적으로 숫자가 전달된다. 따라서 JIT 컴파일러는 앞으로도 숫자가 전달될 가능성이 높다고 판단하고 숫자 연산에 특화된 기계어를 생성한다.
일반적인 JavaScript + 연산은 여러 가능성을 고려해야한다.
- 입력값 확인
- 숫자인지 확인
- 문자열인지 확인
- 객체라면 원시 값 변환이 필요한지 확인
- 필요한 JavaScript 타입 변환 수행
- 실제 덧셈 또는 문자열 연결
반면 두 입력이 특정 숫자 표현이라고 가정하면 더 단순한 경로를 생성할 수 있다.
- 입력이 예상한 숫자 표현인지 확인
- CPU의 숫자 연산 수행
- 결과 반환
이 방식은 객체 프로퍼티 접근에도 적용할 수 있다.
1
2
3
4
5
6
7
8
9
function getX(object) {
  	return object.x;
}

const point = {x : 10, y : 20}

for (let i = 0; i < 10000; i++) {
  	getX(point);
}
getX()에 전달되는 객체가 반복적으로 같은 구조를 가진다면 V8은 x 프로퍼티의 위치를 매번 일반적인 방식으로 검색하는 대신 특정 객체 구조에 맞는 빠른 접근 코드를 사용할 수 있다.
Guard
추측적 최적화는 어디까지느 추측으로 항상 맞는것은 아니다.
다음 코드에서는 처음에 숫자만 전달되지만 마지막에는 문자열이 전달된다.
1
2
3
4
5
6
7
8
9
function add(a, b) {
  	return a + b;
}

for (let i = 0; i < 100000; i++) {
  	add(i, 1);
}

add("hello", "world");
숫자 연산에 특화된 기계어는 문자열 연결을 그대로 처리할 수 없다.
그렇다고 최적화된 코드가 입력을 확인하지 않고 CPU의 숫자 덧셈 명령을 실행하면 JavaScript 명세와 다른 잘못된 결과가 발생할 수 있다.
따라서 최적화된 코드에는 자신이 세운 가정이 여전히 맞는지 확인하는 검사가 포함된다. 이러한 검사를 Guard 라고 한다.
Guard를 사용하면 일반적인 모든 경우를 매번 처리하지 않으면서도 예상하지 못한 값이 들어왔을 때 정확한 JavaScript 동작으로 돌아갈 수 있다.
Deoptimization
최적화 코드가 의존한 가정이 더이상 성립하지 않으면 해당 최적화 코드를 그대로 계속 실행할 수 없다.
이때 V8은 최적화된 실행 상태를 더 일반적인 실행 상태로 복원한다. 이 과정을 Deoptimization 줄여서 Deopt라고 한다.
Depotimization에서 여러운 점은 함수를 처음부터 다시 실행할 수 없다는 것이다.
예를 들어 최적화된 함수가 이미 작업을 수행했을 때 발생한 부수 효과를 모두 취소하고 함수 처음으로 돌아갈 수는 없다.
따라서 V8은 최적화된 코드의 현재 실행 지점에 대응하는 인터프리터 상태를 복원해야 한다.
개념적으로 다음 정보가 필요하다.
- 현재 바이트코드 위치는 어디인가
- 각 JavaScript 변수의 현재 값은 무엇인가
- 레지스터에 들어있는 값은 어느 변수에 해당하는가
- 최적화 과정에서 제거한 값은 어떻게 다시 구성하는가
- 호출 스택은 어떤 상태여야 하는가
Maglev와 TurboFan은 deoptimization이 가능한 지점에 최적화 상태를 비최적화 상태로 복원하기 위한 메타데이터를 유지한다. 가정이 깨지면 deoptimizer가 레지스터와 스택 등에 존재하는 값을 읽어 인터피르터가 계속 실행할 수 있는 형태로 상태를 재구성한다.
흐름은 다음과 같다.
- 최적화 가정이 깨진다
- 현재 최적화 코드의 실행 상태를 저장한다.
- 해당 지점에 대응하는 비최적화 상태를 재구성한다.
- 일반적인 코드에서 실행을 이어간다.
- 필요하면 이후 새로운 피드백을 기반으로 다시 최적화한다.
Tiered Compliation
Tiered Compilation은 코드의 실행 빈도와 현재까지 수집된 정보에 따라 서로 다른 실행 단계를 사용하는 방식이다.
- 빠른 초기 실행
- 낮은 비용의 기계어 컴파일
- 중간 수준의 최적화
- 높은 수준의 최적화
한번만 실행되는 함수라면 복잡한 최적화를 수행해도 얻는 이익이 없지만 반복적으로 실행되는 함수는 더 높은 단계로 이동한다.
이를 개념적으로 Cold, Warm, Hot 상태로 나눠 생각한다.
- Cold Code : 실행 횟수가 적음
- Warm Code : 어느 정도 반복 실행되고 기계어 컴파일의 이익이 생김
- Hot Code : 매우 자주 실행되고 컴파일 비용을 사용한 최적화가 유리함
On-Stack Replacement
일반적인 함수 호출에서는 현재 함수 실행이 끝난 뒤 다음 호출부터 최적화된 코드를 사용할 수 있다.
하지만 한번 호출된 함수 내부에서 매우 긴 반복문이 실행되는 경우가 있다 함수가 반환된 뒤 다음 호출부터 최적화 코드를 사용한다면 첫번째 호출의 긴 반복문에서는 최적화의 이점을 얻지 못한다.
이 문제를 해결하기 위해 OSR(On-Stack Replacement)를 사용한다.
OSR은 현재 실행 중인 함수 프레임을 최적화된 코드의 실행 상태로 전환하는 기술이다.
- 인터프리터로 반복문 실행
- 반복문이 Hot Code
- 최적화된 코드 생성
- 현재 실행 중인 반복문의 상태 변환
- 최적화된 코드에서 반복문 실행
함수가 끝날때까지 기다리지 않고 현재 실행 도중에 최적화 코드로 이동한다는 점이 중요하다. V8은 오래 실행되는 hot loop가 있는 함수에서 현재 실행 중인 함수를 최적화 코드로 교체하기 위해 OSR을 사용한다.
Deopt & OSR
- OSR : 비최적화 상태 -> 최적화 상태
- Deopt : 최적화 상태 -> 비최적화 상태
V8에서의 JIT
Ignition
Ignition은 V8의 바이트코드 인터프리터이다. V8 공식 문서에서는 Ignition을 낮은 수준의 레지스터 기반 인터프리터라고 한다.
레지스터 기반 인터프리터라는 것은 바이트코드의 피연산자와 중간 결과를 가상의 레지스터를 중심으로 관리한다는 의미이다.
여기서 말하는 레지스터는 CPU의 레지스터가 아니라 인터프리터가 관리하는 논리적인 레지스터이다.
Ignition은 생성된 바이트코드를 빠르게 실행하기 시작하고 실행 과정에서 다음 최적화에 필요한 피드백을 수집할 수 있다.
- 어떤 타입이 전달되었는가
- 이 프로퍼티 접근에서 어떤 객체 Map이 관찰되었는가
- 이 호출 지점에서 어떤 함수가 호출되었는가
초기 실행부터 모든 함수를 기계어로 만들지 않기 때문에 코드 메모리를 절약할 수 있고 거의 실행되지 않는 함수에 불필요한 최적화 비용을 사용하지 않아도 된다. Ignition은 기존 baseline 기계어보다 더 간결한 바이트코드를 사용해 메모리 사용량을 줄이기 위한 목적으로 도입되었다.
Sparkplug
Sparkplug는 V8의 non-optimizing baseline compiler이다. Ignition 인터프리터와 최적화 컴파일러 사이에 위치한다.
Ignition이 바이트코드를 실행할 때는 다음 과정이 반복된다.
- 바이트코드를 읽는다
- 명령의 종류를 확인한다
- 해당 바이트코드 핸들러로 이동한다.
- 핸들러를 실행한다.
- 다음 바이트코드로 이동한다.
이를 Bytecode Dispatch Overhead라고 볼 수 있다.
Bytecode Dispatch Overhead
Bytecode Dispatch Overhead는 프로그램이 기계어로 직접 실행되지 않고 가상 머신(VM)이나 인터프리터(예: JVM, Python, JavaScript 엔진)를 거칠 때, 가상 머신이 실행할 명령어(Bytecode)를 하나씩 읽어 해석하고 적절한 실제 기계어 명령으로 분기(Dispatch)하는 과정에서 발생하는 추가적인 시간과 연산 비용(간접비)을 의미한다.
동일한 코드가 반복 실행되면 이 해석 비용도 계속 반복된다. Sparkplug는 바이트코드를 CPU가 직접 실행할 수 있는 기계어로 컴파일한다.
1
Ignition -> Sparkplug -> Machine Code
Sparkplug는 바이트코드와 유사한 흐름으로 기계어를 빠르게 생성한다. 복잡한 중간 표현을 만들고 수많은 최적화 패스를 수행하는 대신 컴파일 시간을 최소화 하면서 인터프리터보다 빠른 실행 코드를 만드는데 집중한다.
따라서 Sparkplug는 실행 횟수가 어느 정도 증가했지만 아직 높은 수준의 최적화 비용을 사용할 정도는 아닌 코드에 사용한다.
Maglev
Maglev는 Sparkplug와 TurboFan 사이에 위치하는 빠른 optimizing compiler이다.
V8은 Maglev를 Chrome 117에 도입했으며 Sparkplug보다 강한 최적화를 수행하면서 TurboFan보다 빠르게 코드를 생성하는 것을 목표로 한다.
Maglev는 Ignition이 수집한 실행 피드백을 이용해 추측적 최적화를 수행한다.
예를 들어 다음과 같은 가정을 할 수 있다.
1
2
3
이 연산의 입력은 숫자이다.
이 객체는 주로 특정 Map을 가진다.
이 호출 지점에는 주로 하나의 함수가 호출된다.
이러한 가정을 사용하면 Maglev는 Gaurd와 Deopt를 지원해야 한다.
- 수집된 피드백
- Maglev가 최적화 코드 생성
- 실행 중 Guard로 가정 확인
- 가정이 맞음 -> Fast path 실행
- 가정이 틀림 -> Deopt
Maglev는 Deopt가 가능한 노드에 인터프리터 프레임 상태를 연결하고 이를 바탕으로 최적화 상태에서 인터프리터 상태를 재구성할 수 있는 메타데이터를 생성한다.
TurboFan
TurboFan은 V8의 높은 수준의 최적화를 담당하는 optimizing compiler이다. 다음 정보를 이용해 최적화된 기계어를 생성할 수 있다.
- Ignition Bytecode
- Runtime Feedback
- 객체의 Map 정보
- 연산에 전달된 타입
- 호출 지점의 대상 함수
- 제어 흐름
- 데이터 흐름
TurboFan은 코드를 내부 중간 표현인 IR로 변환한 뒤 여러 최적화 단계를 수행한다.
Constant Folding
컴파일 시점에 계산할 수 있는 연산을 미리 계산한다.
1
2
3
function calculate() {
    return 10 + 20;
}
개념적으로 다음처럼 최적화할 수 있다.
1
2
3
function calculate() {
    return 30;
}
Dead Code Elimination
실행 결과에 영향을 주지 않는 코드를 제거한다.
1
2
3
4
function example() {
    return 10;
    console.log("unreachable");
}
return 뒤의 도달 불가능한 코드는 제거 대상이 될 수 있다.
Function Inlining
작은 함수의 본문을 호출 지점에 직접 삽입해 함수 호출 비용을 줄이고 추가 최적화 기회를 만든다.
1
2
3
4
5
6
7
function addOne(x) {
    return x + 1;
}

function calculate(value) {
    return addOne(value) * 2;
}
개념적으로 다음과 비슷한 형태로 바뀔 수 있다.
1
2
3
function calculate(value) {
    return (value + 1) * 2;
}
Type-Specific Optimization
실행 피드백을 기반으로 특정 타입에 특화된 연산을 생성한다.
Redundant Check Elimination
앞에서 이미 확인되어 다시 검사할 필요가 없는 조건을 제거할 수 있다.
다만 이러한 최적화는 실제 V8 내부 IR과 의존 관계를 바탕으로 수행되므로, 소스 코드가 항상 위 예시 그대로 변환된다는 뜻은 아니다.
정리
JIT은 프로그램 실행 중에 코드를 기계어로 컴파일하는 방식이다.
전체 과정은 다음과 같다.
- JavaScript Source Code
- Parser
- AST
- Bytecode
- Ignition
- Runtime Feedback Collection
- Sparkplug
- Maglev
- TurboFan
- Optimized Machine Code
각 구성요소의 역할은 다음과 같다.
| 구성 요소 | 역할 |
|---|---|
| Ignition | 바이트코드를 실행하는 인터프리터 |
| Sparkplug | 바이트코드를 빠르게 기계어로 변환하는 baseline 컴파일러 |
| Maglev | 비교적 낮은 컴파일 비용으로 최적화된 코드를 생성하는 컴파일러 |
| TurboFan | 높은 실행 성능을 목표로 강한 최적화를 수행하는 컴파일러 |
| Turboshaft | TurboFan 등의 최적화 파이프라인 내부에서 사용되는 CFG 기반 IR 및 컴파일러 인프라 |
실행 빈도가 낮은 코드는 Ignition에 머무를 수 있고 반복적으로 실행되는 코드는 Sparkplug, Maglve, TurboFan과 같은 단계로 이동할 수 있다.
최적화 컴파일러는 실행 중 수집된 정보를 바탕으로 추측적 최적화를 수행하고 가정이 깨지면 역최적화를 통해 일반적인 실행 상태로 돌아간다.